100.000 $ Ersparnis pro Abonnement
Heute spart der Kunde rund 100.000 $ pro Abonnement.
Implementierung des Data Warehouse, des ELT-Prozesses, des Kundenportals und der Berichte.
[ Kunde ]
Ein Anbieter von Technologielösungen für die Automobilindustrie.
[ Herausforderung ]
Der Kunde bezog seit Jahren elektronische Ersatzteilkataloge und gab dafür monatlich zwischen 5.000 $ und 50.000 $ pro Katalog aus.
Unser Team nahm die Herausforderung an, eine Lösung zu entwickeln, die die Kataloge von fünf Herstellern auf Basis der Quelldaten generiert und aktualisiert.
[ Lösung ]
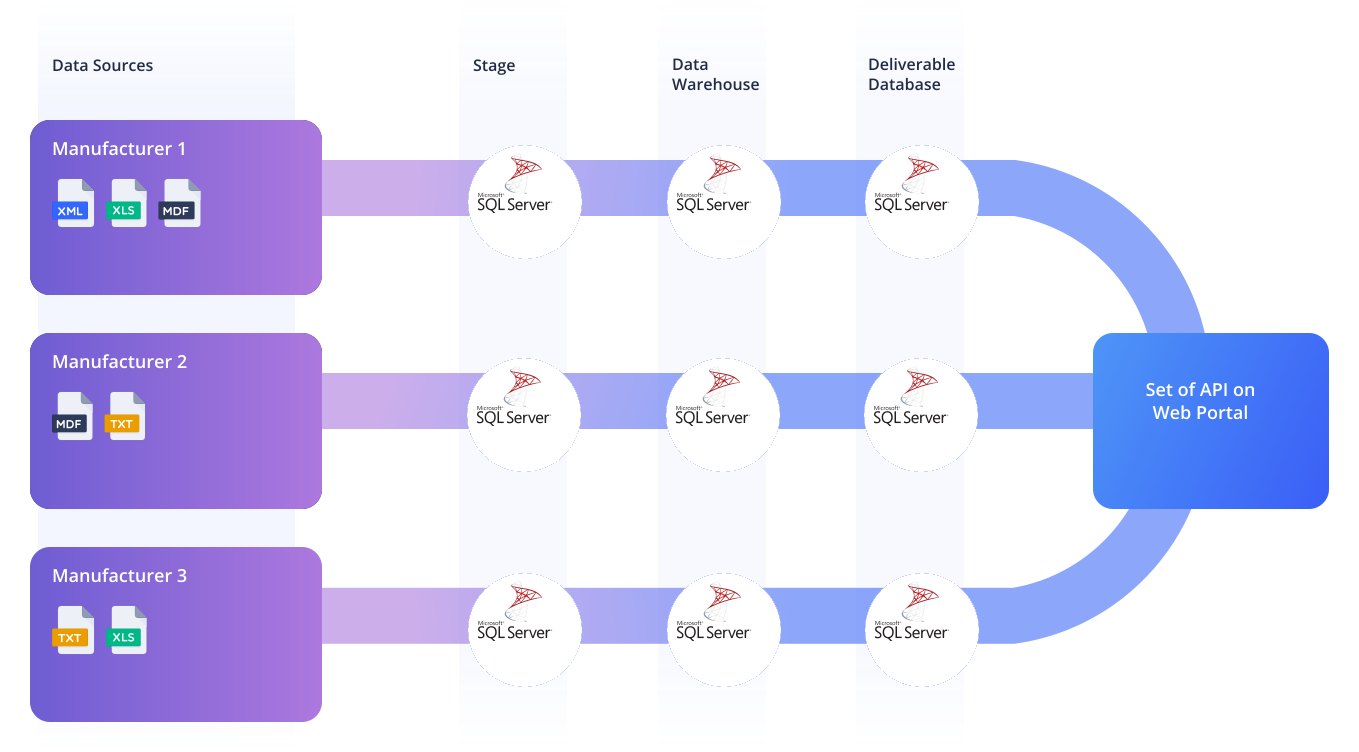
Jeder Hersteller liefert seine Quelldaten in einem eigenen Format — Textdateien, XML, Excel, Datenbanken (.MDF) und sogar EBCDIC, ein Format, das seit den 1950er Jahren auf IBM-Mainframes verwendet wird. Ziel war es, ETL-Pipelines aufzubauen, die die unterschiedlichen Quelldaten transformieren und es ermöglichen, alle Kataloge über einen einzigen Satz von APIs abzufragen.
Stage — Rohdaten werden in eine MS-SQL-Datenbank importiert und anschließend bereinigt und validiert. Die Stage enthält nur einen Satz verarbeiteter Daten, der zu Beginn jedes ETL-Durchlaufs geleert wird. Das Data Warehouse ist ein permanenter Datenspeicher mit integrierten und normalisierten Datensätzen (kein kanonisches Data Warehouse).
Die Deliverable Database enthält Daten mit angewandten Geschäftsregeln und Transformationen, die für den Zugriff über APIs erforderlich sind. Die APIs wiederum sind als SQL-Prozeduren implementiert.
[ Ergebnisse ]
Der Kunde erstellt und pflegt nun alle fünf Kataloge intern, wodurch wiederkehrende Abonnementkosten für externe Anbieter entfallen und er die volle Kontrolle über Aktualisierungen gewinnt.
Heute spart der Kunde rund 100.000 $ pro Abonnement.
Hochwertige Kataloge sparen Ressourcen bei der Wartung.
Wir haben vollen Zugriff auf die Kataloge sowie die Möglichkeit geschaffen, sie jederzeit zu aktualisieren.
[ Fallstudien ]
Wir haben über 200 Unternehmen dabei unterstützt, ihren Geschäftswert zu steigern und ihre Arbeitsweise durch bessere Software zu optimieren.
Lassen Sie uns über Ihre Ziele sprechen und darüber, wie wir Sie dabei unterstützen können, sie zu erreichen.