- Transformacja AI rzadko kończy się porażką z powodu zbyt słabego modelu. Częściej dlatego, że firma nie ma jasnych zasad dotyczących danych, ryzyka i kontroli na produkcji.
- Ramy odpowiedzialnej AI można wdrożyć w trzech krokach: audyt obecnego wykorzystania AI, jasne granice dla danych (zielone/żółte/czerwone) i scentralizowany dostęp przez zatwierdzone narzędzia.
- Dostęp do AI warto scentralizować przez zatwierdzone narzędzia enterprise, prywatne API, Azure AI, AWS Bedrock lub podobne bezpieczne bramy, aby zachować kontrolę nad promptami, logami i wynikami.
Firmowe inicjatywy AI zwykle zaczynają się od mocnego poparcia zarządu i pierwszych pilotaży proof of concept, które wyglądają jak magia. Zespoły świętują te pierwsze sukcesy w środowiskach przedprodukcyjnych, często przekonane, że od wdrożenia produkcyjnego dzielą je tylko tygodnie. Kilka miesięcy później te same pilotaże stoją jednak w miejscu. Zostają w środowiskach deweloperskich i nigdy nie trafiają na produkcję.
Przyczyną rzadko jest wadliwy kod, nieodpowiednia infrastruktura czy słabe przetwarzanie tokenów. W wielu przypadkach wdrożenie utyka, ponieważ zespół inżynierski i kierownictwo nie mają ram potrzebnych do zarządzania rozwiązaniem przy prawdziwym ruchu.
Brutalna prawda jest taka, że transformacja AI bardzo często jest problemem zarządczym, a nie technologicznym. Prawdziwa przewaga konkurencyjna leży w kontroli. Sukces zależy od tego, jak bezpiecznie system obchodzi się z danymi, prywatnością i zgodnością z przepisami. Skalowanie AI bez ścisłych zabezpieczeń jedynie zwiększa ryzyko prawne.
W tym artykule omawiamy rolę zarządzania AI (AI governance) i dzielimy się rekomendacjami opartymi na naszym praktycznym doświadczeniu, które pomagają zachować kontrolę nad transformacją AI.
Transformacja AI nie jest problemem technologicznym
Pięć lat temu tworzenie AI było zarezerwowane dla elity inżynierów. Potrzebny był duży zespół wysoko wykwalifikowanych data scientistów, dedykowana infrastruktura serwerowa i spory budżet badawczy. Ta wysoka bariera wejścia trzymała większość firm z dala od rynku.
Ta bariera zniknęła. Dziś pojedynczy programista może w kilka minut podłączyć się do zaawansowanego API. Może bezpłatnie pobrać czołowy model open source i uruchomić go lokalnie.
Gdy zniknęło tarcie technologiczne, wąskie gardło przesunęło się. Główne wyzwanie nie leży już poza firmą. Kwestia techniczna przerodziła się w prawdziwy kryzys zarządzania. Dane pokazują, że choć organizacje szybko modernizują swoje pipeline'y danych, ich ramy organizacyjne nie nadążają. Według badania McKinsey & Company średni wskaźnik dojrzałości w zakresie odpowiedzialnej AI (RAI) wzrósł z 2,0 w 2025 roku do 2,3 w 2026 roku.
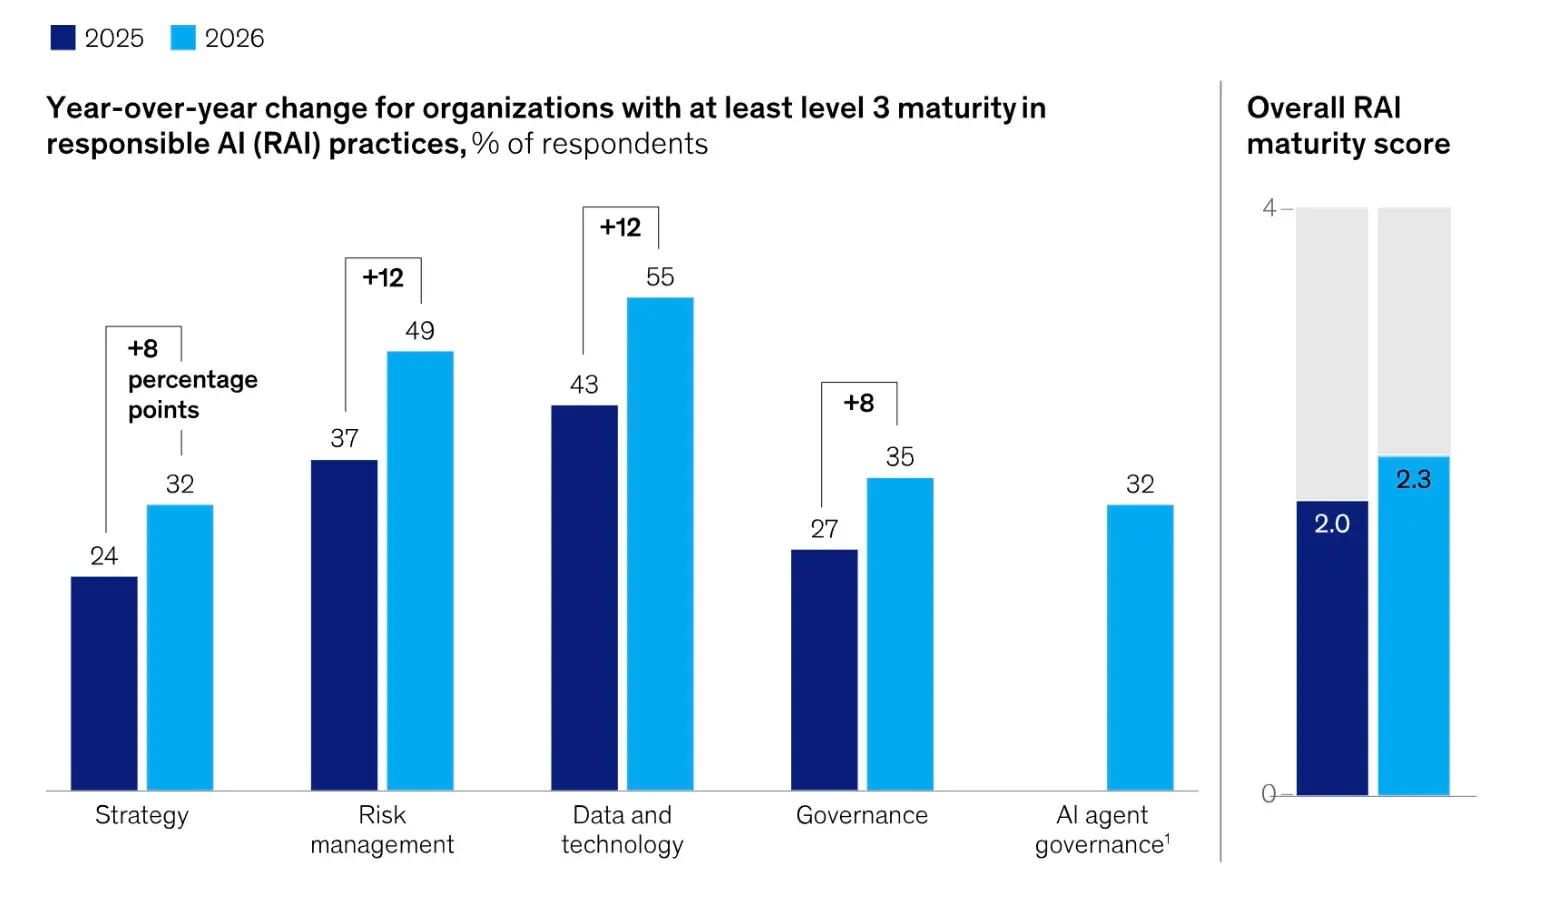
55% organizacji osiągnęło wysoki poziom dojrzałości w praktykach dotyczących danych i technologii. Tymczasem tylko 35% osiągnęło porównywalną dojrzałość w podstawowym zarządzaniu. To właśnie ta operacyjna asymetria wyjaśnia, dlaczego funkcje biznesowe utykają tuż przed wdrożeniem produkcyjnym.
Widzimy, że klienci często zadają niewłaściwe pytanie. Chcą wiedzieć: „Czy da się zbudować tę funkcję AI?”. Odpowiedź zawsze brzmi: tak. Technologia na to pozwala. Planując nowe funkcje AI, trzeba jednak uwzględnić ukryte ryzyka operacyjne. Przed wdrożeniem jakiegokolwiek modelu na produkcję należy odpowiedzieć na trzy konkretne pytania.
Dokąd trafiają dane firmy, gdy pracownik korzysta z tego narzędzia? Jeśli programiści wysyłają niekontrolowane zapytania do endpointów zewnętrznych dostawców, firmowy kod i dane klientów lądują w cudzych logach. W ten sposób własność intelektualna firmy zasila cudze modele.
Kto ponosi odpowiedzialność prawną, gdy AI udzieli klientowi złej porady? Modele potrafią halucynować pod presją. Błędnie interpretują złożone teksty i mogą wymyślać fałszywe statystyki. Jeśli klient podejmie kroki prawne z powodu błędnego, zautomatyzowanego wyniku, odpowiedzialność spada w całości na firmę, a nie na dostawcę modelu.
Jak śledzić i uzasadniać rosnące koszty chmury? Tokeny wydają się tanie, dopóki nie pojawi się prawdziwy ruch produkcyjny. Bez wyraźnego limitowania zapytań (rate limiting) i cache'owania nieoczekiwany skok użycia może w jeden weekend wyczerpać miesięczny budżet infrastrukturalny.
Co w praktyce oznacza zarządzanie AI?
Wielu menedżerów postrzega zarządzanie AI jako biurokratyczny hamulec, który paraliżuje rozwój i dusi innowacje. To jednak błędne podejście.
Warto myśleć o zarządzaniu jak o hamulcach w wyczynowym samochodzie sportowym. Inżynierowie nie montują mocnych hamulców po to, by auto jechało wolniej. Montują je, aby kierowca mógł pokonywać ostre zakręty bez utraty kontroli. Samochód z potężnym silnikiem, ale bez hamulców, rozbije się na pierwszym okrążeniu.
Zarządzanie AI działa jak układ hamulcowy infrastruktury. Zapewnia kontrolę strukturalną, której zespół potrzebuje, aby bezpiecznie przyspieszać. Dla organizacji działających na rynku europejskim zarządzanie AI staje się też obowiązkiem regulacyjnym w związku z unijnym aktem w sprawie sztucznej inteligencji (AI Act). Rozporządzenie nakłada obowiązki w zakresie zarządzania ryzykiem, przejrzystości, nadzoru człowieka i dokumentacji w zależności od poziomu ryzyka systemu AI.
Oto, co można osiągnąć dzięki właściwemu podejściu do zarządzania AI.
Przejrzystość operacyjna
Nie da się zarządzać systemem, którego się nie widzi. Bardzo możliwe, że w tej chwili pracownicy kopiują wrażliwe pliki firmowe i tabele z danymi klientów do publicznych, darmowych narzędzi AI. Według raportu KnowBe4 około 51% pracowników korzysta z niezatwierdzonych aplikacji lub narzędzi AI z pominięciem wewnętrznych zasad. Takie „shadow AI” od razu tworzy luki w bezpieczeństwie.
Przejrzystość wymaga wdrożenia scentralizowanego systemu kontroli. Trzeba zinwentaryzować każdy używany zewnętrzny endpoint AI, monitorować, które usługi z niego korzystają, i precyzyjnie kontrolować, jakie dane opuszczają sieć firmy.
Zgodność z przepisami i bezpieczeństwo
Modele dobrze działają w kontrolowanych środowiskach przedprodukcyjnych, ale przy prawdziwym ruchu ich jakość często spada. Bezpieczeństwo wymaga wdrożenia zautomatyzowanych kontroli na poziomie infrastruktury, które weryfikują odpowiedzi modelu, zanim dotrą do użytkownika końcowego.
System musi systematycznie sprawdzać, czy zautomatyzowane odpowiedzi są zgodne z przepisami branżowymi, wewnętrznymi zasadami ochrony danych i prawem autorskim. Jeśli model wygeneruje błędne twierdzenie, warstwa bezpieczeństwa powinna automatycznie zablokować odpowiedź.
Kontrola finansowa
Rozliczanie za tokeny wydaje się korzystne, gdy narzędzie AI testuje pięć osób. Gdy jednak korzystają z niego tysiące klientów, staje się bardzo kosztowne. Bez technicznych zabezpieczeń koszty API rosną liniowo wraz z ruchem.
Aby lepiej planować i kontrolować budżet w dłuższej perspektywie, warto zapoznać się z naszym szczegółowym przewodnikiem o kosztach tworzenia AI.
Nieprzewidziany skok użycia lub niekontrolowana pętla zapytań może w jeden weekend pochłonąć cały budżet na chmurę obliczeniową. Zarządzanie finansowe oznacza wprowadzenie ścisłych limitów zapytań i cache'owania, dzięki którym miesięczne koszty są w pełni przewidywalne.
Ryzyka niekontrolowanej transformacji AI
Wdrażanie modeli bez ograniczeń na poziomie infrastruktury od razu tworzy podatności operacyjne. Prawdziwa transformacja AI wymaga systematycznej kontroli pipeline'ów danych. Bez niej firma jest narażona na trzy wyraźnie odmienne zagrożenia strukturalne.
Niezauważony dryf modeli
Modele tracą jakość na produkcji, w miarę jak zmieniają się rzeczywiste zachowania użytkowników i wzorce danych. Tradycyjne oprogramowanie zwraca standardowy kod błędu albo powoduje awarię serwerów. Z modelem AI jest inaczej: działa pozornie bez zarzutu, generując coraz mniej trafne lub nieistotne wyniki.
Badanie z 2025 roku dotyczące degradacji systemów AI wskazuje, że spadek wydajności jest nieodłącznym wyzwaniem długoterminowych wdrożeń AI. Dotyczy zarówno klasycznych modeli machine learning, jak i nowoczesnych dużych modeli językowych.
Bez monitoringu w czasie rzeczywistym to zjawisko pozostaje całkowicie niezauważone. Zespół inżynierski odkrywa problem dopiero wtedy, gdy kluczowe wskaźniki użytkowników gwałtownie spadają. Dlatego ciągły monitoring, wykrywanie dryfu i regularne aktualizacje modeli są niezbędne.
Kaskadowe awarie systemów wieloagentowych
Nowoczesne systemy firmowe opierają się na wielu połączonych agentach AI, które realizują złożone przepływy pracy. W takiej konfiguracji jeden model przekazuje swój tekstowy wynik jako bezpośrednie wejście techniczne do kolejnego mikroserwisu.
Jeśli pierwszy model popełni drobny błąd formatowania lub subtelny błąd logiczny, zostaje on wykładniczo wzmocniony w całym pipeline. Cały łańcuch agentów może wtedy wpaść w nieskończone pętle lub uszkodzić bazy danych, windując rachunek za tokeny i powodując awarię krytycznych aplikacji.
Ryzyka prawne i wizerunkowe
Gdy agent AI obsługujący klientów wymyśli fałszywe ceny lub ujawni dane osobowe użytkownika, konsekwencje prawne bezpośrednio uderzają w wynik finansowy firmy. Zewnętrzny dostawca modelu nie dzieli z nią odpowiedzialności. Jego warunki licencji enterprise w pełni chronią go przed sporami firmy z jej klientami końcowymi.
Jak pokazuje badanie McKinsey & Company, obawy związane z bezpieczeństwem i ryzykiem, a także niepewność regulacyjna i braki technologiczne należą do głównych przeszkód w skalowaniu agentowej AI.
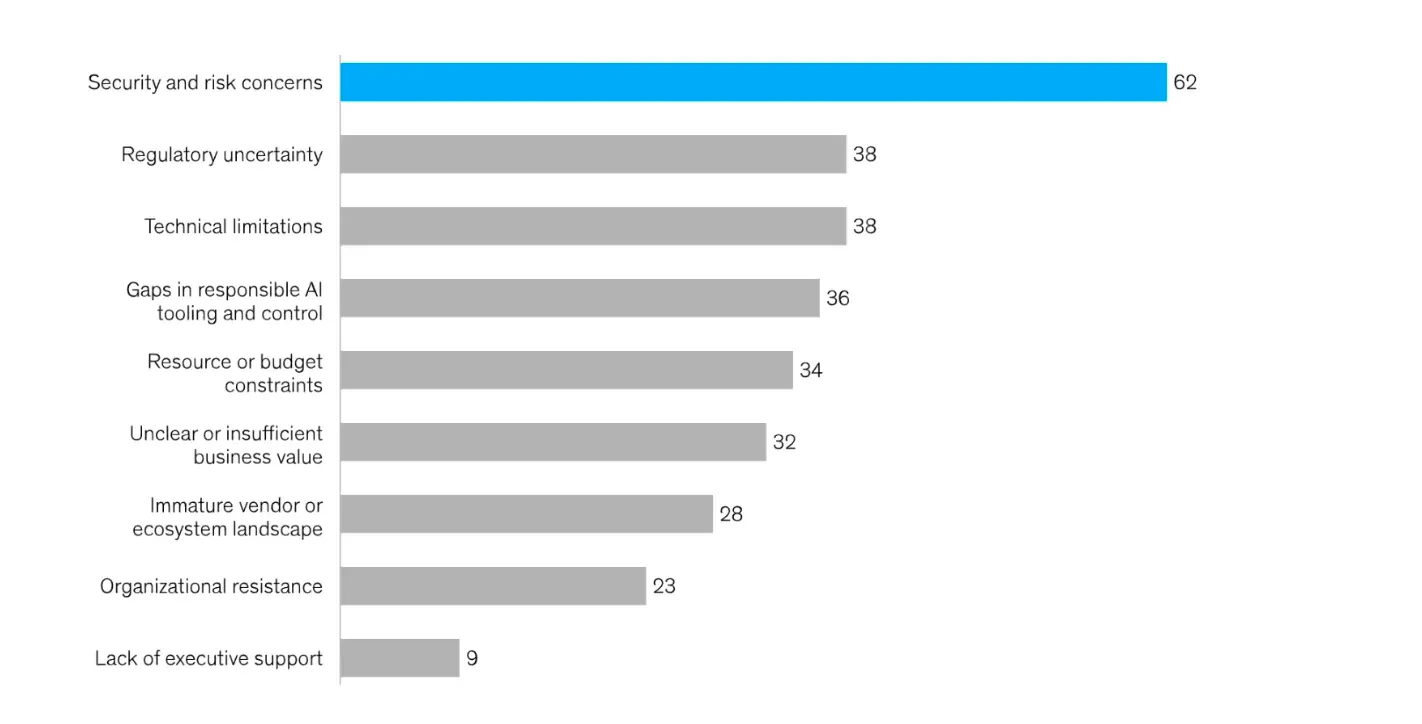
Firma pozostaje prawnie i finansowo odpowiedzialna za każdą wygenerowaną odpowiedź i każde naruszenie przepisów. Aby ograniczyć tę ekspozycję, trzeba wdrożyć rygorystyczne ramy odpowiedzialnej AI. Takie techniczne zabezpieczenia działają jak zautomatyzowane filtry zgodności: przechwytują i odrzucają niebezpieczne odpowiedzi, zanim dotrą do użytkowników końcowych.
Jak wdrożyć ramy odpowiedzialnej AI
Wdrożenie konkretnych zabezpieczeń nie wymaga sześciu miesięcy badań ani nowego kodu. Zespoły mogą chronić swoje przepływy pracy od razu, bez utraty tempa rozwoju.
Krok 1. Przeprowadzenie audytu AI
Pracownicy często korzystają z niezatwierdzonych narzędzi AI do pisania e-maili czy planowania zadań. Ścisłe zakazy nie działają, bo pracownicy po prostu ukrywają korzystanie z nich. Zamiast tego warto przeanalizować narzędzia, z których korzystają zespoły, aby zrozumieć ich rzeczywiste potrzeby operacyjne.
Dobrym punktem wyjścia jest krótka, anonimowa ankieta, w której zespoły wskazują, z jakich narzędzi AI korzystają, aby ułatwić sobie pracę, jakie dane do nich wprowadzają i jakie luki one wypełniają.
Zrozumienie obecnej sytuacji pozwala precyzyjnie określić, gdzie leżą potrzeby operacyjne, i w pierwszej kolejności zabezpieczyć te przepływy pracy.
Krok 2. Wyznaczenie jasnych granic
Złożone, 50-stronicowe polityki zgodności rzadko ktoś czyta. Aby zarządzanie danymi było faktycznie stosowane, potrzebny jest prosty system, który każdy zapamięta od pierwszego dnia pracy. Sprawdza się system klasyfikacji danych oparty na sygnalizacji świetlnej.
Kategoria zielona obejmuje publiczne treści marketingowe, dokumentację open source i ogólne badania branżowe. Pracownicy mogą swobodnie używać ich w dowolnym publicznym LLM.
Kategoria żółta obejmuje notatki wewnętrzne, zanonimizowane opinie klientów i wskaźniki operacyjne. Te dane można wykorzystywać wyłącznie w narzędziach zatwierdzonych przez firmę, które gwarantują poufność danych.
Kategoria czerwona obejmuje firmowy kod źródłowy, dane medyczne klientów lub pacjentów, dane finansowe i dane osobowe (PII). Te dane nigdy nie powinny trafiać do publicznego modelu komercyjnego.
Krok 3. Centralizacja punktu dostępu
Jeśli firma jedynie zakaże publicznych narzędzi AI, nie oferując realnej alternatywy, pracownicy nieuchronnie zaczną korzystać z prywatnych kont na własnych urządzeniach. Zamiast blokować dostęp, znacznie rozsądniej jest zaoferować lepszą opcję.
Warto udostępnić scentralizowaną, zatwierdzoną przez firmę bramę. Może to być przejście na wersje enterprise wiodących LLM lub wdrożenie prostego wewnętrznego portalu webowego opartego na prywatnym API.
W ten sposób znika motywacja do obchodzenia zasad. Pracownicy zyskują wzrost produktywności, którego szukają, a firma zachowuje niezbędną kontrolę nad swoimi danymi.
Te trzy kroki nie wprowadzają żadnych przeszkód, które mogłyby spowolnić transformację AI. Wręcz przeciwnie: pozwalają zbudować solidne fundamenty, które rozwijają się w tempie technologii.
Bezpieczna transformacja AI: podejście Akveo
W Akveo jesteśmy przekonani, że sprostanie wyzwaniu zarządzania AI wymaga wdrożenia w systemie jasno zdefiniowanych warstw izolacji danych. Stosujemy wielopoziomową strategię architektoniczną, aby dane firmy w całości pozostawały w bezpiecznych granicach.
Standardowa izolacja przez API
Domyślnie korzystamy z dostawców modeli takich jak Anthropic czy OpenAI. Platformy te stosują ścisłe zasady braku przechowywania danych (Zero Data Retention, ZDR) i niewykorzystywania ich do trenowania. Dane firmy nigdy nie są używane do trenowania publicznych modeli. To podstawowy poziom bezpiecznego wdrażania funkcji.
Separacja na poziomie infrastruktury
Dla organizacji objętych rygorystycznymi wymogami rezydencji danych kierujemy te same modele przez AWS Bedrock lub Microsoft Azure AI. To nie jest zwykłe proxy: AWS i Microsoft fizycznie hostują niezależne kopie modeli we własnej, odizolowanej infrastrukturze serwerowej.
Gdy Claude działa przez Bedrock, Anthropic nie ma żadnego dostępu do promptów, logów ani wyników. Dane nigdy nie opuszczają istniejącego środowiska chmurowego firmy i w całości podlegają jej obecnym umowom dotyczącym zgodności w chmurze. Stosujemy tę architekturę u klientów wdrażających AI w usługach finansowych, opiece zdrowotnej i sektorze prawnym.
Wdrożenia self-hosted
Gdy organizacja zabrania jakichkolwiek zewnętrznych połączeń sieciowych, opcją pozostają modele hostowane we własnym zakresie. Nie proponujemy ich jednak jako rozwiązania podstawowego. Instalacje lokalne mogą oferować niższą wydajność i zwiększać koszty infrastruktury. Dlatego przed wyborem tej opcji niezbędna jest staranna ocena jej zasadności.
Podsumowanie
Wdrożenia AI kończą się porażką, gdy zespoły inżynierskie traktują modele generatywnej AI jak zwykłe bloki tradycyjnego kodu. Modele są z natury niestabilne. Zarządzanie zapewnia precyzyjną telemetrię techniczną potrzebną do wykrywania dryfu modeli i hamowania zużycia tokenów, zanim odbije się ono na wyniku finansowym.
Aby przejść od nieprzewidywalnych skryptów testowych do stabilnej produkcji, potrzebne są solidne fundamenty. W Akveo budujemy bezpieczne granice danych, które chronią firmowe dane, a jednocześnie zwiększają możliwości oprogramowania. I zawsze jesteśmy gotowi wspierać rozwój Państwa firmy.
Najczęściej zadawane pytania
Czym jest transformacja AI?
Transformacja AI to strategiczny proces integrowania sztucznej inteligencji na wszystkich poziomach organizacji. Zmienia sposób, w jaki firma działa, podejmuje decyzje i tworzy wartość dla klientów. Przeprojektowując przepływy pracy i rozwijając kompetencje zespołów, firmy zamieniają swoje dane w kluczową przewagę konkurencyjną, która napędza zrównoważony wzrost.
Czym jest zarządzanie AI (AI governance)?
Zarządzanie AI to zbiór zasad i praktyk, które zapewniają, że organizacja korzysta ze sztucznej inteligencji bezpiecznie i odpowiedzialnie. Obejmuje wyznaczenie jasnych zabezpieczeń w zakresie prywatności danych i zgodności z przepisami. Dzięki zarządzaniu ryzykiem i przejrzystości firmy zdobywają zaufanie użytkowników i unikają problemów prawnych i operacyjnych.
Jakie są główne ryzyka skalowania AI bez zabezpieczeń na poziomie infrastruktury?
Brak kontroli prowadzi do niewidocznych wycieków danych, gdy pracownicy kopiują wewnętrzne pliki lub dane klientów do niezatwierdzonych narzędzi publicznych. Zwiększa też ryzyko niezauważonego dryfu modeli: z czasem mogą one generować coraz mniej trafne wyniki, nie zgłaszając przy tym tradycyjnego błędu. Wreszcie powoduje kaskadowe awarie w systemach wieloagentowych. Nawet drobne błędy formatowania lub logiki między połączonymi mikroserwisami mogą uszkodzić bazy danych i wywindować rachunek za chmurę.